Artificial Intelligence · Stable Concepts

هوش مصنوعی؛ از مفاهیم ماندگار شروع کنید.

در مدیر ملی، بخش هوش مصنوعی روی مفاهیمی تمرکز می‌کند که با عوض‌شدن نام محصولات از بین نمی‌روند: مدل زبانی چگونه کار می‌کند، داده چگونه به نمایش برداری تبدیل می‌شود، RAG چگونه دانش بیرونی را وارد پاسخ می‌کند و دسترسی مدل به ابزار چه تغییری در ریسک و طراحی سامانه ایجاد می‌کند.

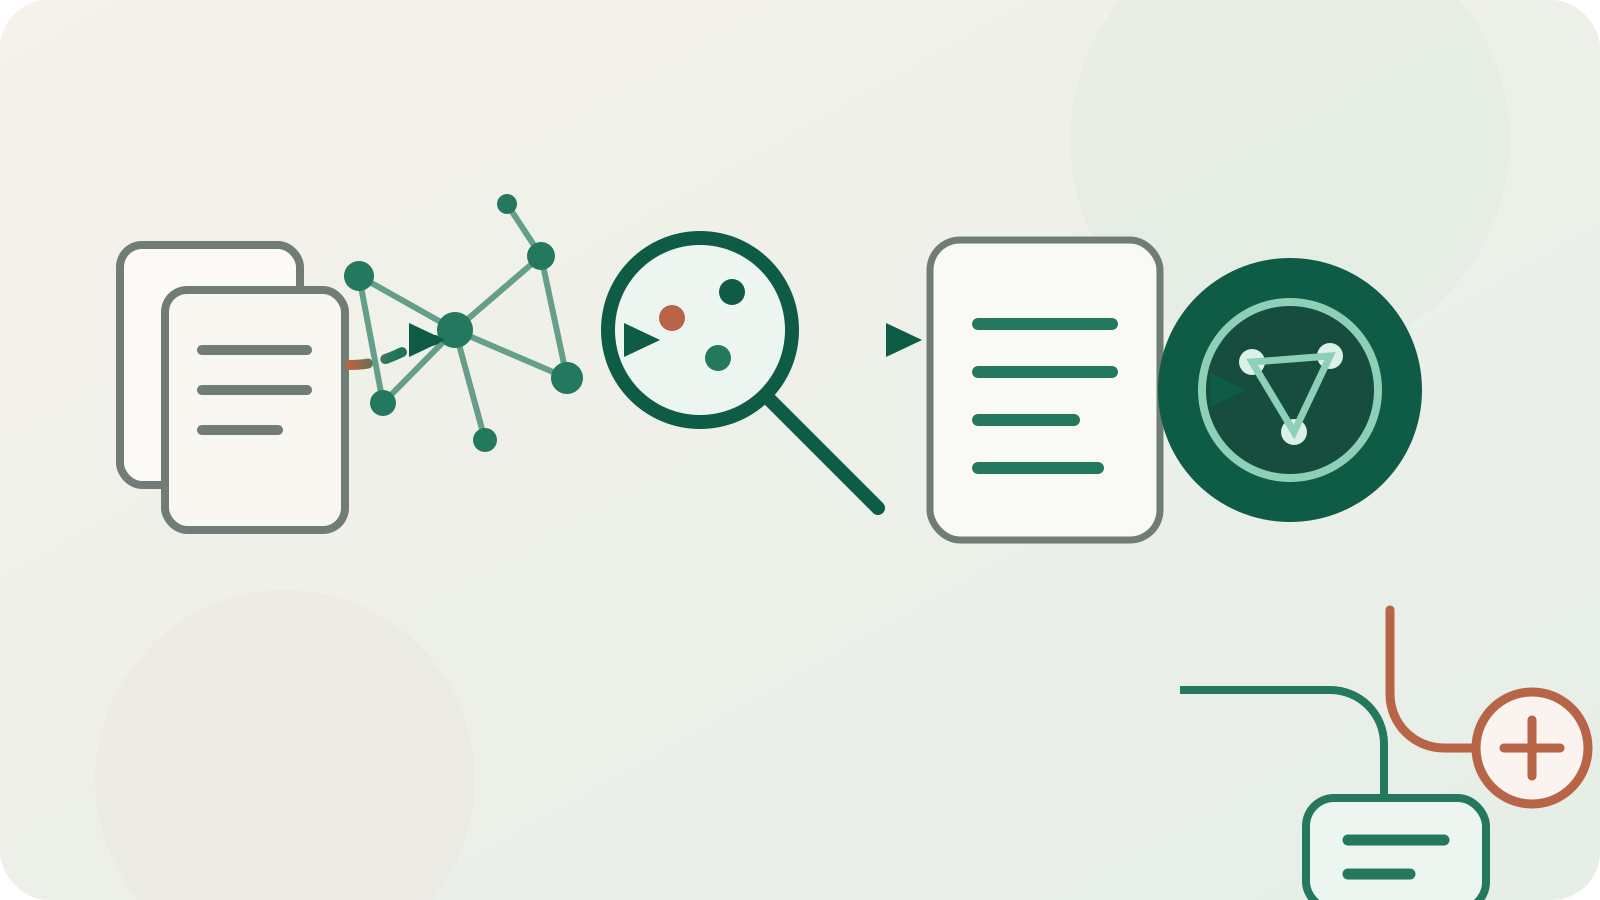
نمودار انتزاعی مسیر منابع و داده به تعبیه برداری، بازیابی، زمینه انتخاب‌شده، مدل زبانی و سپس پاسخ یا استفاده از ابزار
مدل تنها یک لایه است

یک سامانه واقعی را از «منبع» تا «اقدام» ببینید.

اسناد و داده ابتدا باید قابل بازیابی شوند؛ embedding و retrieval فقط بخش انتخاب زمینه‌اند. بعد مدل زبانی روی همان زمینه پاسخ می‌سازد و اگر به ابزار متصل باشد، یک شاخهٔ جدا برای اقدام بیرونی شکل می‌گیرد. هر شاخه معیار خطا و کنترل خودش را می‌خواهد.

این تصویر یک نقشهٔ مفهومی است، نه معماری اجباری برای همه سامانه‌ها.

نقشه مفاهیم

پنج مفهوم پایه که بهتر است از هم جدا بمانند

هر مدخل تعریف، کاربرد، محدودیت و منبع اصلی خودش را دارد. هدف این است که «مدل»، «دانش»، «بازیابی» و «اقدام» در ذهن مدیر یکی نشوند.

Large Language Model

مدل زبانی بزرگ (LLM)

مدل زبانی بزرگ یا LLM مدلی آماری و عصبی برای برآورد توزیع دنباله‌های زبانی است که با داده و ظرفیت محاسباتی زیاد آموزش می‌بیند و معمولاً متن را با پیش‌بینی واحد بعدی زبان تولید یا امتیازدهی می‌کند. بسیاری از LLMهای امروزی بر معماری ترنسفورمر بنا شده‌اند، اما «بزرگ» یک مرز عددی ثابت و علمی ندارد.

تعریف و منبع ←
Transformer Architecture

معماری ترنسفورمر

ترنسفورمر یک معماری شبکه عصبی برای پردازش دنباله‌هاست که هسته آن بر سازوکار توجه (attention) تکیه دارد. این سازوکار به مدل اجازه می‌دهد هنگام ساخت نمایش هر بخش از ورودی، وزن متفاوتی به بخش‌های دیگر بدهد. این معماری در شکل‌های رمزگذار (encoder)، رمزگشا (decoder) یا ترکیب رمزگذار-رمزگشا به کار می‌رود و پایه بسیاری از مدل‌های زبانی جدید است.

تعریف و منبع ←
Vector Embedding

تعبیهٔ برداری (Embedding)

تعبیهٔ برداری روشی برای نمایش یک شیء مانند واژه، جمله، سند یا تصویر به‌صورت برداری از اعداد است؛ به‌گونه‌ای که ساختار و شباهت‌های آموخته‌شده در داده تا حدی در هندسه این فضا بازتاب پیدا کند. شباهت برداری ابزار محاسباتی مفیدی است، اما معادل فهم انسانی یا رابطه علّی نیست.

تعریف و منبع ←
Retrieval-Augmented Generation (RAG)

تولید تقویت‌شده با بازیابی (RAG)

RAG خانواده‌ای از معماری‌هاست که پیش از یا هنگام تولید پاسخ، اطلاعات مرتبط را از یک منبع بیرونی بازیابی می‌کند و آن زمینه را در اختیار مدل مولد می‌گذارد. در شکل رایج، یک پرسش به نمایش قابل بازیابی تبدیل می‌شود، اسناد یا قطعه‌های مرتبط انتخاب می‌شوند و مدل پاسخ را با اتکا به آن زمینه تولید می‌کند.

تعریف و منبع ←
Language Model Tool Use

استفادهٔ مدل زبانی از ابزار

استفاده از ابزار یعنی مدل زبانی به‌جای محدودماندن به تولید متن، بتواند در چارچوبی کنترل‌شده یک ابزار بیرونی مانند جست‌وجو، پایگاه داده، ماشین‌حساب یا رابط برنامه‌نویسی کاربردی (API) را انتخاب و فراخوانی کند و نتیجه را دوباره وارد فرایند پاسخ یا تصمیم کند. ابزار، توانایی بیرونی اضافه می‌کند؛ اما اختیار و سطح دسترسی باید جداگانه کنترل شود.

تعریف و منبع ←

چه چیزهایی را ماندگارتر می‌دانیم؟

نام مدل‌ها، رتبه‌بندی‌ها، رابط‌های محصول و قیمت‌ها سریع تغییر می‌کنند؛ برای یک دانشنامه مرجع انتخاب خوبی نیستند. در عوض، معماری ترنسفورمر، مدل‌سازی زبانی، نمایش برداری، بازیابی اطلاعات و اتصال مدل به ابزار مفاهیمی‌اند که برای فهم نسل بزرگی از سامانه‌ها کاربرد دارند.

این به معنی ثابت‌بودن همه جزئیات فنی نیست. پژوهش ادامه دارد، اما این مفاهیم یک زبان مشترک می‌دهند تا بتوانید درباره طراحی، ریسک و ارزیابی سامانه حرف بزنید بدون اینکه صفحه به نام یک محصول خاص وابسته شود.

یک سامانه هوش مصنوعی فقط «مدل» نیست

در کاربرد سازمانی بهتر است سامانه را لایه‌لایه ببینید: مدل پایه، دستور و زمینه، منبع دانشی، retrieval، ابزارها و APIها، سیاست دسترسی، ثبت رویداد، ارزیابی و کنترل انسانی. خطا ممکن است در هرکدام از این لایه‌ها شکل بگیرد.

برای همین مقایسه صرفِ مدل‌ها کافی نیست. یک مدل قوی با retrieval ضعیف، داده قدیمی یا اختیار بیش از حد می‌تواند سامانه نامطمئنی بسازد؛ برعکس، معماری کنترل‌شده با منبع روشن و ارزیابی دامنه‌ای ممکن است برای یک کار محدود ارزش بیشتری داشته باشد.

  • مدل: چه نوع خروجی تولید می‌کند و محدودیت زمینه آن چیست؟
  • دانش: پاسخ از پارامترهای مدل می‌آید یا از منبع بیرونی قابل ردیابی؟
  • ابزار: سامانه چه چیزی را فقط می‌خواند و چه چیزی را می‌تواند تغییر دهد؟
  • ارزیابی: خطای قابل قبول برای این کاربرد چیست و با چه داده‌ای سنجیده می‌شود؟
  • حاکمیت: چه کسی اختیار، مسئولیت، بازبینی و توقف سامانه را در دست دارد؟

پنج سؤال مدیریتی قبل از استفاده جدی

پیش از خرید یا ساخت سامانه، مسئله را از فناوری جدا کنید. اول روشن کنید چه تصمیم یا کاری قرار است بهتر شود؛ سپس منبع داده، سطح اختیار، پیامد خطا و سازوکار ارزیابی را مشخص کنید.

  • اگر سامانه اشتباه کند، فقط متن بد تولید می‌شود یا می‌تواند پول، پرونده، مجوز یا خدمت را تغییر دهد؟
  • اطلاعات لازم در خود مدل است یا باید از اسناد سازمان با RAG بازیابی شود؟
  • منبع پاسخ برای کاربر یا بازبین قابل مشاهده و پیگیری است؟
  • چه کسی می‌تواند ابزار یا سطح دسترسی سامانه را تغییر دهد؟
  • چه نمونه‌های واقعی و چه معیارهایی قبل و بعد از استقرار برای ارزیابی داریم؟
حکمرانی آینده

Agentic AI را فعلاً «سناریوی نهادی» ببینید، نه یک حقیقت تثبیت‌شده.

وقتی مدل زبانی به حافظه، ابزار، API و حلقه اقدام متصل می‌شود، بحث فقط کیفیت متن نیست؛ سطح اختیار، ثبت رویداد، مسئولیت خطا، امکان توقف و نظارت انسانی وارد مسئله حکمرانی می‌شوند. معماری‌های عامل‌محور سریع تغییر می‌کنند، بنابراین این موضوع در مدیر ملی به‌صورت brief منبع‌دار و سناریویی نگهداری می‌شود.

خواندن brief «Agentic AI و حکمرانی آینده» ←

حکمرانی

برای فهم قدرت، پاسخ‌گویی، اختیار و هماهنگی که با عامل‌های نرم‌افزاری دوباره صورت‌بندی می‌شوند.

آینده‌پژوهی

برای بررسی چند آینده ممکن به‌جای فرض‌کردن یک مسیر قطعی برای هوش مصنوعی.

یادداشت برای دور بعدی

چه چیزی در این صفحه درست نیست؟

یادداشت روی همین هاست ثبت می‌شود و در صف خصوصیِ بازخورد می‌ماند تا در نوبت بعدی به فهرست اقدام منتقل شود.